
فایل Robots.txt چیست و چگونه کار میکند؟ آموزش ساخت، دستورها و نمونهها
اگر در حال یادگیری مطالب مرتبط با سئو هستید و با مفهومی به نام «فایل Robots.txt» روبرو شدهاید و نمیدانید چیست، جای درستی آمدهاید! ما در این مقاله مطالبی را که در مورد این مفهوم نیاز دارید به شما یاد میدهیم. در انتها خواهید دانست که: Robots.txt چیست؟ چه مزایایی دارد و نحوه ساخت آن چگونه است. پس تا انتهای این مقاله با پاسخ همراه ما باشید.
برای خواندن سریع هر بخش، روی عنوان آن کلیک کنید
Robots.txt چیست؟
Robots.txt یک فایل متنی است که به موتورهای جستجو مانند گوگل میگوید که میخواهید چه صفحاتی در وبسایت شما ایندکس یا خزیده شوند.
- robots.txt به رباتها میگوید کدام بخشهای سایت را نخزند؛ ابزاری برای کنترل خزش است، نه ایندکس.
- مسدود کردن صفحه در robots.txt آن را از نتایج حذف نمیکند؛ برای این کار از noindex استفاده کنید.
- از ۲۰۱۹ گوگل دستور noindex داخل robots.txt را پشتیبانی نمیکند.
- امروزه میتوان دسترسی رباتهای هوش مصنوعی مثل GPTBot را هم با robots.txt مدیریت کرد.
موتورهای جستجو همیشه به دنبال بهبود نتایج خود و دسترسی کاربران به به روزترین و بهترین اطلاعات هستند. برای این کار، از رباتهایی استفاده میکنند که با نام عنکبوت یا خزنده شناخته میشوند. این رباتها به طور خودکار صفحات وب که اخیرا منتشرشده را باز میکنند و سپس تصمیم میگیرند که آیا محتوا باید ایندکس شود یا خیر.
هنگام پردازش سایت، خزندهها یکی از 3 دستورالعمل زیر را دریافت میکنند:
- دسترسی جزئی (اسکن عناصر تکی سایت در دسترس است)
- دسترسی کامل (ربات میتواند هر چیزی را اسکن کند)
- ممنوعیت اسکن (ربات نمیتواند چیزی را اسکن کند)
بهطور پیشفرض، وبسایتها به موتورهای جستجو اجازه میدهند که تمام صفحات آنها را خزیده و فهرستبندی کنند، زیرا میخواهند در نتایج جستجو بالا روند و ترافیک بالاتری را به دست بیاورند. با این حال، گاهی اوقات صاحبان وبسایتها میخواهند صفحاتی را که ایندکس میشوند محدود کنند تا در پهنای باند صرفهجویی کنند و یا برخی از صفحات را خصوصی نگهدارند.
در این شرایط فایل robots.txt وارد عمل میشود!
فایل robots.txt چطور عمل میکند؟
وقتی رباتها برای اولینبار یک وبسایت را باز میکنند، فایل robots.txt را پیدا میکنند. فایل robots.txt یک سند متنی است که در دایرکتوری ریشه یک سایت قرار دارد و حاوی اطلاعاتی است که برای خزندههای موتورهای جستجو در نظر گرفته شده است؛ در مورد اینکه کدام URLها (صفحات، فایلها، پوشهها و غیره) باید خزیده شوند و کدامها نباید خزیده شوند. در حقیقت سه نوع دستورالعملی که رباتها برای خزش هر قسمت از سایت دریافت میکنند (در قسمت قبل درباره آن صحبت کردیم)، توسط این فایل در اختیار آنها قرار داده میشود.
وجود این فایل برای عملکرد وبسایت اجباری نیست، اما در عین حال، راهاندازی صحیح آن در هسته سئو نهفته است.
به گفته مرکز راهنمای گوگل، هدف اصلی این فایل جلوگیری از نمایش صفحات وب در نتایج جستجو نیست، بلکه محدودکردن تعداد درخواستهای رباتها به سایتها و همچنین کاهش بار سرور است.
به طور کلی، محتوای فایل robots.txt باید به عنوان یک توصیه برای خزندههای جستجوگر در نظر گرفته شود که قوانین خزیدن وبسایت را تعریف میکند. برای دسترسی به محتوای فایل robots.txt هر سایت، تنها کاری که باید انجام دهید این است که “/robots.txt” را بعد از نام دامنه در مرورگر تایپ کنید.
اگر رباتها دستورالعملهایی را از فایل robots.txt دریافت نکنند، از روشهای نمایهسازی خود استفاده میکنند.
مزایای استفاده از Robots.txt
این فایل مزایای زیادی به همراه دارد که به شرح زیر هستند:
1. به دسترسی مناسب به مطالب وبسایت کمک میکند
robots.txt تنها فایلی است که مانند دروازهای برای نمایش وبسایت در موتور جستجو عمل میکند. اگر از اسکریپتها برای نوشتن پروتکلها در توسعه فایل robots.txt استفاده کرده باشید، حتما متوجه شدهاید که وبسایت مستقیماً در موتور جستجو نمایش داده میشود.
هر خزنده موتور جستجو، پروتکل خاص خود را برای دسترسی به وبسایت شما دارد. فایل robots.txt کمک میکند تا محتوای وبسایت شما توسط موتور جستجو به درستی کشف شود. در حقیقت این فایل مانند راهنمای سایت شما عملکرده و درک صفحات را برای ربات آسان میکند.
2. موتور جستجو را از دسترسی به فایلهای خصوصی منع میکند
اگر فایلی وجود دارد که شما نمیخواهید در سرچ گوگل دیده شده و ایندکس شود، این اختیار را دارید که با استفاده از این فایل، قوانینی را برای موتورهای جستجو بگذارید که به این فایل دسترسی نداشته باشند.
فایلهای خصوصی ممکن است فایلهای اداری، صفحات ورود، صفحه برگشتخوردن ایمیل یا سندهای مالی ذخیرهشده در سرور باشند. از آنجایی که برخی فایلها ممکن است برای کسبوکار شما محرمانه باشند و یا شما نخواهید کاربران به آن محتوای آنها در موتور جستجو دسترسی داشته باشند، فایل Robots.txt میتواند نقش منجی را برای شما بازی کند.
3. حفظ شهرت وبسایت
هنگامی که صفحاتی از سایت شما که برای کاربر نهایی مناسب نیست در موتور جستجو نمایه میشوند، تأثیر منفی بر مخاطبان هدف دارند. به همین دلیل است که فایل robots.txt طوری تنظیم میشود که مشتریان را به صفحات فهرستبندی مرتبط با کاربران هدایت کند و مواردی را که برای آنها مفید نیست، نشان ندهد.
4. عدم نمایش سایت در زمانی که در حال ساخت است
robots.txt معمولاً زمانی که وبسایت در حال توسعه است، آن را برای کاربران غیر قابل دسترسی میکند. مطمئنا شما نمیخواهید که رباتها و کاربران با صفحات نامرتب و درحال ساخت شما روبرو شوند.
به همین ترتیب، میتوانید این تکنیک را برای صفحه خاصی در وبسایت خود که درحال تغییر یا ایجاد آن هستید، پیادهسازی کنید. اگر مطالب نامرتب و بد سایت شما ایندکس شود، بر نتایج سئوی شما تاثیر منفی میگذارد و فایل Robots.txt شما را از این مشکل نجات میدهد.
5. کمک به سئو
این فایل نقش زیادی در بهبود سئوی تکنیکال شما دارد. از آنجا که محتوای تکراری میتواند مشمول پنالتی شود، اگر صفحات تکراری دارید میتوانید با استفاده از فایل Robots.txt دسترسی گوگل به آنها را محدود کنید. علاوه بر این، میتوانید یک نمای شستهورفته از سایت خود در اختیار خزنده قرار دهید تا سایت را به خوبی بشناسد. به عبارت دیگر میتوانید نقشه سایت را با استفاده از فایل Robots.txt تهیه کنید.
نحوه ساخت یک Robots.txt استاندارد
برای ایجاد یک فایل robots.txt باید چهار مرحله را پشت سر بگذارید:
- یک فایل با نام txt ایجاد کنید.
- دستورالعملها را به فایل txt اضافه کنید.
- فایل متنی را در وبسایت خود آپلود کنید.
- فایل را تست کنید.
ایجاد فایلهای robots.txt
یک فایل با نام Robots.Txt ایجاد کنید
برای ایجاد یک فایل robots.txt، باید از یک ویرایشگر متن ساده مانند notepad یا TextEdit استفاده کنید. مطمئن شوید که فایل خود را با کد نویسی UTF-8 ذخیره کردهاید.
- فایل txt باید robots.txt نامگذاری شود.
- هر سایتی میتواند یک فایل از این نوع داشته باشد.
- برای کنترل خزیدن در تمام URL های وبسایت، باید فایل txt را در دایرکتوری ریشه وبسایت قرار دهید.
دستورالعملها را به فایل Robots.Txt اضافه کنید
دستورالعملها قوانینی هستند که برای خزندهها مشخص میکنند کدام قسمت از سایت را میتوانند بخزند و کدام قسمت را نمیتوانند. هنگام افزودن قوانین به فایل robots.txt خود، دستورالعملهای زیر را در نظر داشته باشید:
- فایل txt از یک یا چند گروه تشکیل شده است.
- هر گروه قوانین و دستورالعملهای متفاوتی دارد، یک دستورالعمل در هر خط. هر گروه با یک خط کاربر-عامل (user-agent) شروع میشود که هدف گروه را مشخص میکند.
- هر گروه دستورالعملهای زیر را به user-agent میدهد:
- گروه برای چه کسانی اعمال میشود (کاربر-عامل)
- کدام فایلها، URLها یا دایرکتوریها را عامل میتواند بخزد؟
- کدام فایلها، URLها یا دایرکتوریها را عامل نمیتواند بخزد.
- خزندههای وب، گروهها را از بالا به پایین پردازش میکنند. یک عامل-کاربر میتواند تنها با یک مجموعه دستورالعمل مطابقت داشته باشد، که اولین و خاصترین گروهی است که با یک عامل-کاربر مشخص مطابقت دارد.
- به طور پیشفرض، یک عامل-کاربر میتواند به هر URL یا فایلی در وبسایت شما دسترسی داشته باشد، مگر اینکه توسط قانون «عدم اجازه» مسدود شده باشد.
- قوانین به حروف کوچک و بزرگ حساس هستند. به عنوان مثال، Disallow: file.asp فقط برای https://www.example.com/file.asp اعمال میشود، اما https://www.example.com/FILE.asp اعمال نمیشود.
- “#” شروع یک کامنت را نشان میدهد.
فایل Robots.Txt را آپلود کنید
پس از ذخیره فایل robots.txt در رایانه، باید آن را برای خزندههای موتور جستجو در دسترس قرار دهید. نحوه آپلود فایل robots.txt در وبسایت کاملاً به سرور و معماری سایت بستگی دارد. میتوانید اسناد شرکت میزبان خود را جستجو کنید یا مستقیماً با آنها تماس بگیرید تا متوجه شوید که فایل را در کجا باید آپلود کنید.
هنگامی که فایل را آپلود کردید، باید آن را تست کنید تا ببینید درست عمل میکند یا نه.
فایل Robots.Txt را تست کنید
برای آزمایش، یک پنجره مرور خصوصی در مرورگر وب خود باز کنید و به محل فایل robots.txt بروید.
به عنوان مثال، https://www.example.com/robots.txt
اگر محتویات فایل robots.txt خود را پیدا کردید، میتوانید به مرحله بعدی تست بروید.
گوگل دو راه برای آزمایش robots.txt ارائه داده است:
1. Robots.Txt Tester در کنسول جستجو
این ابزار میتواند برای فایلهای robots.txt که از قبل در وبسایت شما قابل دسترسی هستند استفاده شود.
2. کتابخانه متن باز Robots.Txt Google
این کتابخانه در جستجوی گوگل برای آزمایش فایل robots.txt به صورت محلی در رایانه شما استفاده میشود.
سخن آخر
فایل robots.txt فایل متنی است که در در دایرکتوری ریشه وبسایت قرار میگیرد و رباتهای خزنده را در داخل سایت هدایت میکند. این فایل به رباتها میگوید که کدام فایلها را اجازه دارند خزش کنند و کدام فایلها یا URLها را اجازه ندارند. همچنین robots.txt کمک زیادی به سئو سایت میکند.
منابع:
https://seranking.com/blog/guide-robots-txt/
https://silvawebdesigns.com/what-exactly-is-a-robots-txt-file-how-does-it-operate/
https://www.ecsion.com/blogs/create-a-robots-txt-file/
دستورهای اصلی robots.txt
| دستور | کاربرد | مثال |
|---|---|---|
| User-agent | تعیین ربات هدف | User-agent: * |
| Disallow | منع خزش مسیر | Disallow: /wp-admin/ |
| Allow | استثنا از Disallow | Allow: /wp-admin/admin-ajax.php |
| Sitemap | معرفی نقشه سایت | Sitemap: https://site.com/sitemap_index.xml |
| * و $ | الگوی عمومی و پایان آدرس | Disallow: /*?s= |
نمونه robots.txt استاندارد برای وردپرس
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /cart/
Disallow: /checkout/

Sitemap: https://example.com/sitemap_index.xml
مدیریت رباتهای هوش مصنوعی
رباتهایی مثل GPTBot (OpenAI)، Google-Extended (آموزش مدلهای هوش مصنوعی گوگل) و ClaudeBot را میتوان با robots.txt مجاز یا محدود کرد. محدود کردن آنها روی رتبه گوگل اثری ندارد، اما ممکن است حضور محتوای شما در پاسخهای ابزارهای هوش مصنوعی را کاهش دهد؛ پس بر اساس استراتژی برند تصمیم بگیرید.
اشتباهات خطرناک در robots.txt
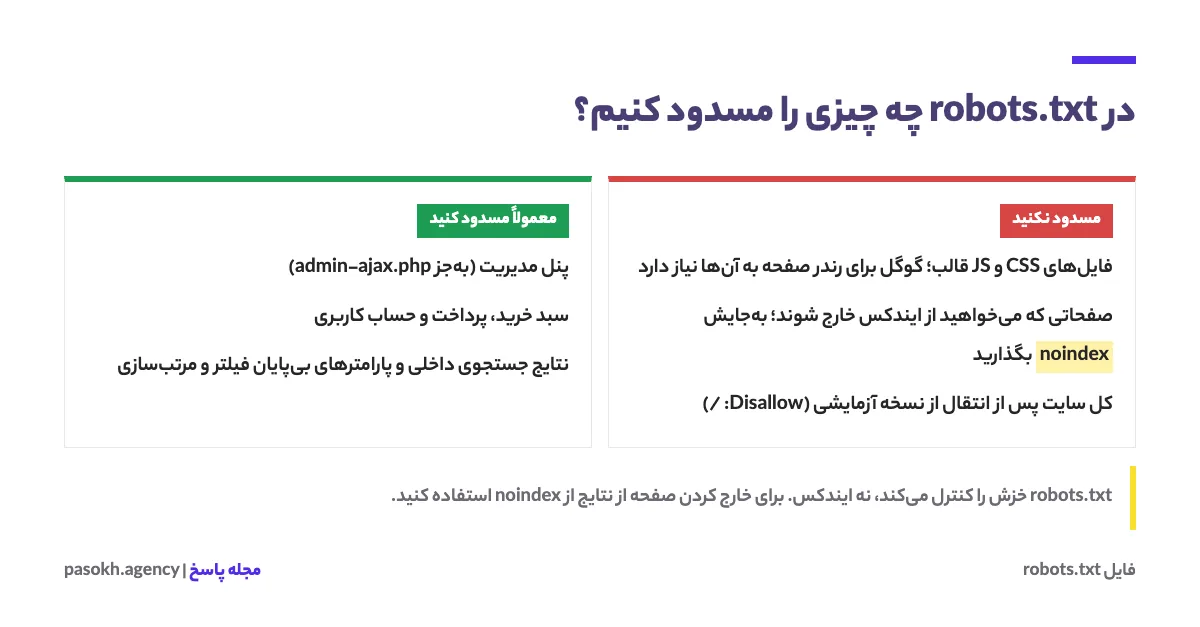
Disallow: /که کل سایت را از خزش خارج میکند (رایج بعد از انتقال از محیط تست).- مسدود کردن فایلهای CSS و JS که مانع رندر درست صفحه توسط گوگل میشود.
- استفاده از robots.txt برای پنهان کردن اطلاعات محرمانه؛ این فایل برای همه قابل مشاهده است.
- مسدود کردن صفحهای که noindex دارد؛ گوگل دیگر نمیتواند noindex را ببیند.
تست robots.txt
ابزار قدیمی robots.txt Tester در سرچ کنسول در سال ۲۰۲۳ کنار گذاشته شد و جای آن را گزارش robots.txt در بخش Settings گرفت که نسخههای دریافتشده و خطاها را نشان میدهد. برای آزمایش یک URL خاص از ابزار URL Inspection استفاده کنید. آموزش سرچ کنسول · تفاوت با متاتگ robots
یک خط اشتباه در robots.txt میتواند کل سایت را از گوگل حذف کند. سئو تکنیکال را به متخصصان بسپارید.
robots.txt برای انواع سایت؛ نمونههای آماده
هیچ فایل robots.txt واحدی برای همه سایتها درست نیست. این نمونهها نقطه شروع هستند و باید با ساختار سایت خودتان تطبیق داده شوند:
فروشگاه اینترنتی ووکامرس
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /*?add-to-cart=
Disallow: /*?orderby=

Sitemap: https://example.ir/sitemap_index.xml
صفحات سبد خرید، پرداخت و حساب کاربری ارزش جستجو ندارند. پارامترهای افزودن به سبد و مرتبسازی هم میتوانند هزاران URL تکراری بسازند و بودجه خزش را هدر دهند.
سایت با جستجوی داخلی
User-agent: *
Disallow: /?s=
Disallow: /search/
صفحات نتایج جستجوی داخلی سایت، محتوای کمارزش و بینهایت تولید میکنند و گوگل توصیه کرده ایندکس نشوند.
رباتهای هوش مصنوعی؛ مسدود کنیم یا نه؟
با گسترش مدلهای زبانی، رباتهای جدیدی برای جمعآوری داده آموزشی یا پاسخگویی در دستیارهای هوش مصنوعی به سایتها سر میزنند. چند نکته برای تصمیمگیری:
| ربات | متعلق به | اثر مسدود کردن |
|---|---|---|
| Google-Extended | گوگل | جلوگیری از استفاده محتوا در آموزش مدلهای Gemini؛ روی رتبه جستجوی گوگل اثری ندارد |
| GPTBot | OpenAI | جلوگیری از جمعآوری محتوا برای آموزش مدلها |
| OAI-SearchBot | OpenAI | ممکن است دیده شدن سایت در پاسخهای جستجوی ChatGPT را کاهش دهد |
| CCBot | Common Crawl | جلوگیری از ورود به مجموعهدادهای که بسیاری از مدلها از آن استفاده میکنند |
تصمیم به کسبوکار شما بستگی دارد: ناشرانی که محتوایشان محصول اصلی است، ممکن است بخواهند جلوی استفاده بدون اجازه را بگیرند؛ کسبوکارهایی که دیده شدن در پاسخهای هوش مصنوعی برایشان ارزش دارد، معمولاً رباتهای جستجو را آزاد میگذارند. به یاد داشته باشید robots.txt یک درخواست است و همه رباتها به آن احترام نمیگذارند.
مسدود کردن Googlebot یعنی حذف تدریجی سایت از نتایج جستجوی گوگل. برای جلوگیری از استفاده در آموزش هوش مصنوعی گوگل، فقط Google-Extended را هدف بگیرید. پیش از انتشار هر تغییر، فایل را با گزارش robots.txt سرچ کنسول بررسی کنید و تفاوت آن با متاتگ robots را فراموش نکنید.
سوالات متداول
فایل robots.txt کجا قرار میگیرد؟
همیشه در ریشه دامنه، مثل example.com/robots.txt؛ در پوشههای دیگر خوانده نمیشود.
برای حذف صفحه از گوگل robots.txt کافی است؟
خیر؛ برای حذف از نتایج از متاتگ noindex استفاده کنید و تا حذف کامل، صفحه را در robots.txt مسدود نکنید.
آیا همه رباتها از robots.txt پیروی میکنند؟
رباتهای معتبر بله، اما رباتهای مخرب ممکن است آن را نادیده بگیرند؛ برای امنیت از روشهای سرور استفاده کنید.
آیا دستور Crawl-delay در گوگل کار میکند؟
خیر؛ گوگل آن را نادیده میگیرد و نرخ خزش را خودکار تنظیم میکند.

متخصص سئو و بازاریابی دیجیتال از سال ۲۰۰۹ دانش آموخته مهندسی نرمافزار از ایران و علوم رسانه و ارتباطات از کشور مجارستان, عاشق سفر و کاوش در فرهنگها، همواره در جستجوی دانش و تجربیات جدید.
همه مطالب ابوالفضل دانش (88)
برای وردپرس پلاگینی هست که بشه باهاش این فایل رو خودکار ساخت؟
بله از مخزن وردپرس قابل دریافت است.